Application desktop d’IA locale

En cours

Alycia

Application desktop C#/.NET et Avalonia pour conversations persistantes et inférence locale via llama.cpp CUDA et modèles GGUF.

Version de travail documentée : les captures et capacités décrites peuvent différer de la branche principale du dépôt public.

Objectif
Fournir une expérience de conversation locale en gardant le fournisseur d’inférence derrière des contrats applicatifs.
Points clés
Architecture en couches, persistance locale, llama.cpp CUDA, GGUF Hugging Face, streaming contenu/raisonnement, tests et observabilité locale.
Desktop IA Architecture
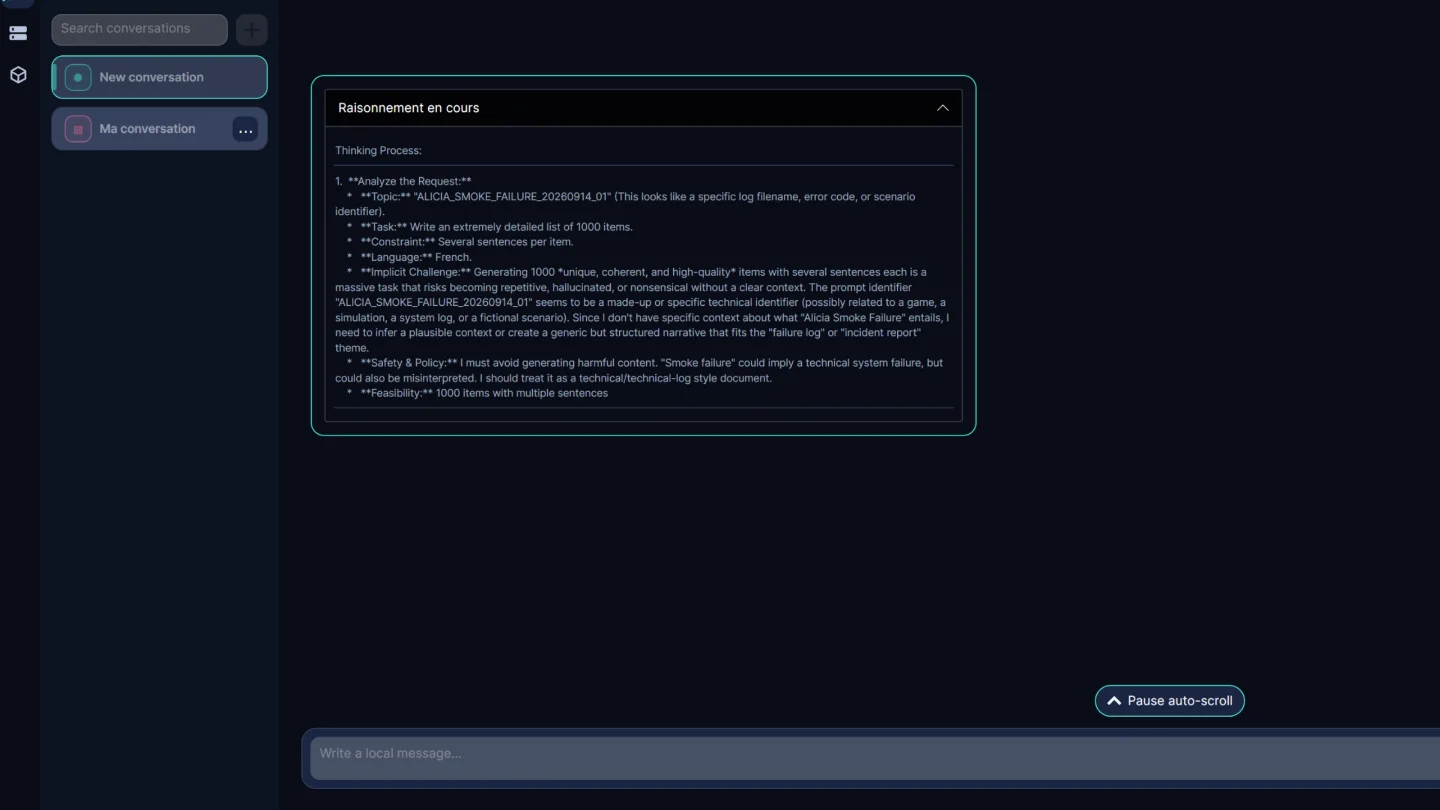
Interface desktop Alycia ouverte sur une conversation locale avec historique, panneau de reasoning et zone de composition.
Conversation locale Alycia avec historique, reasoning séparé et contrôle explicite du streaming.

Problème

Le problème à résoudre

Intégrer llama.cpp comme runtime d’inférence locale sans coupler le domaine de conversation au fournisseur, tout en contrôlant installation, configuration, streaming, annulation et erreurs.

Architecture

Les pièces du système

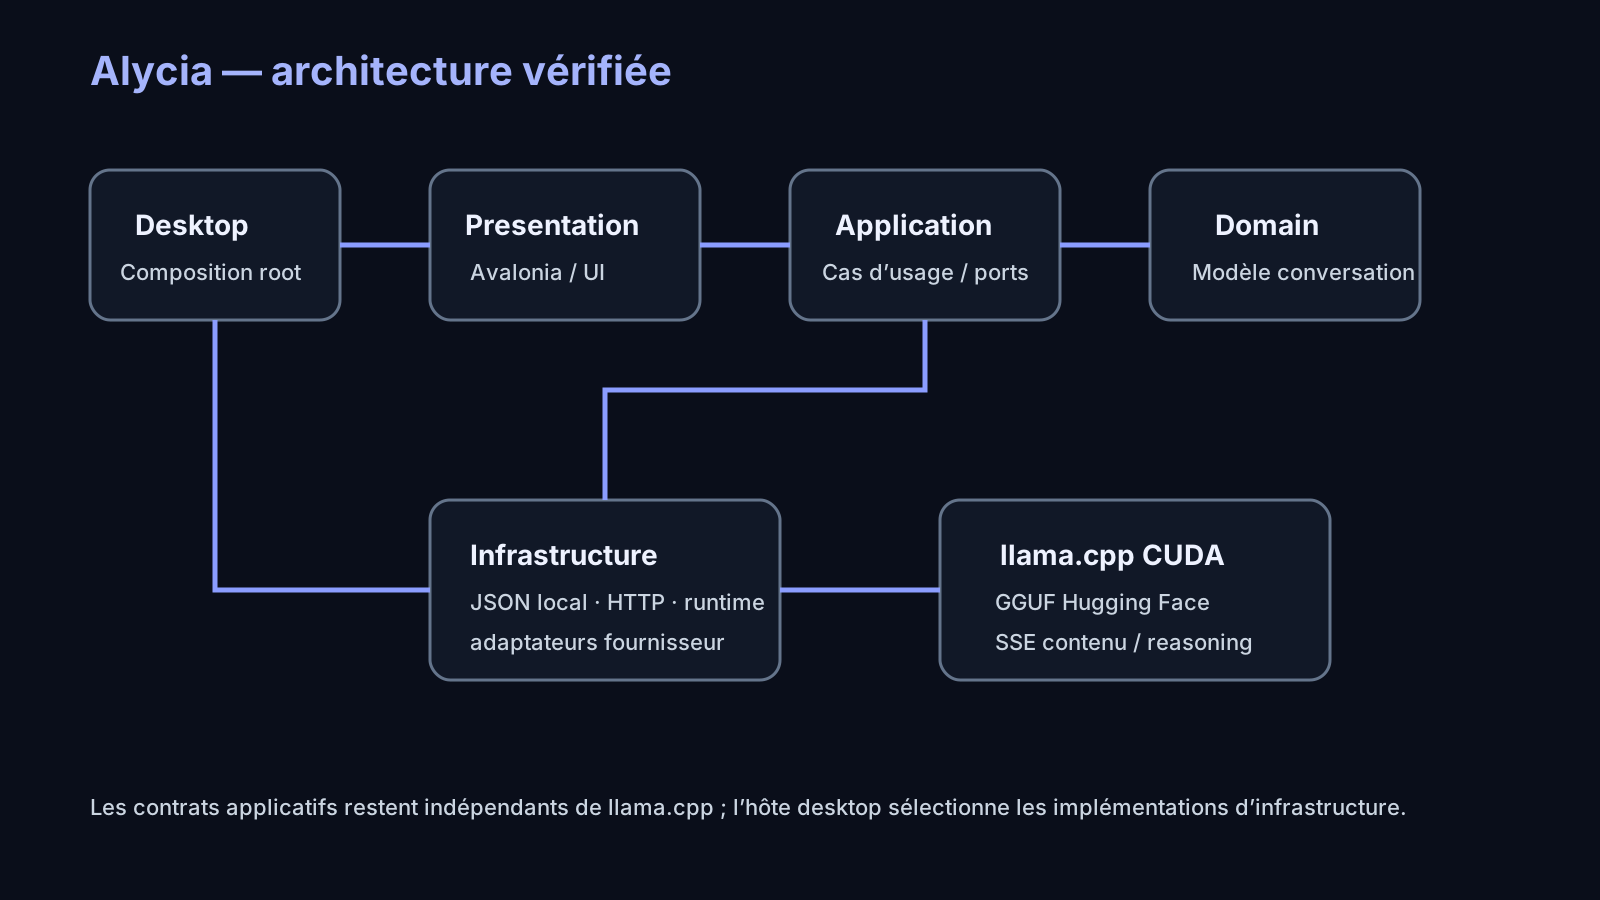
  • La couche Domain porte le modèle de conversation ; Application définit les cas d’usage et ports.
  • Presentation fournit l’interface Avalonia ; Desktop sert de composition root.
  • Infrastructure contient la persistance JSON, les appels HTTP et l’adaptateur llama.cpp local.

Décisions

Décisions techniques

  • Garder le fournisseur hors du domaine. Les contrats de génération et de cycle de vie sont définis côté Application puis implémentés par Infrastructure.
  • Ne pas rejouer automatiquement une génération. Les retries automatiques restent limités aux GET idempotents ; une nouvelle génération exige une action utilisateur explicite.
  • Séparer contenu et reasoning. Le flux UI distingue les deltas visibles du raisonnement et ne persiste que la réponse Assistant terminée.

Schéma

Vue d’ensemble de l’architecture

Le schéma complète l’étude de cas avec les composants et frontières réellement présents dans le projet.

Schéma des couches Desktop, Presentation, Application, Domain et Infrastructure d’Alycia avec llama.cpp.
Architecture en couches et adaptateur local llama.cpp.

Implémentation

Points techniques principaux

  • Cœur de conversation indépendant du fournisseur avec persistance locale JSON et opérations de cycle de vie testées.
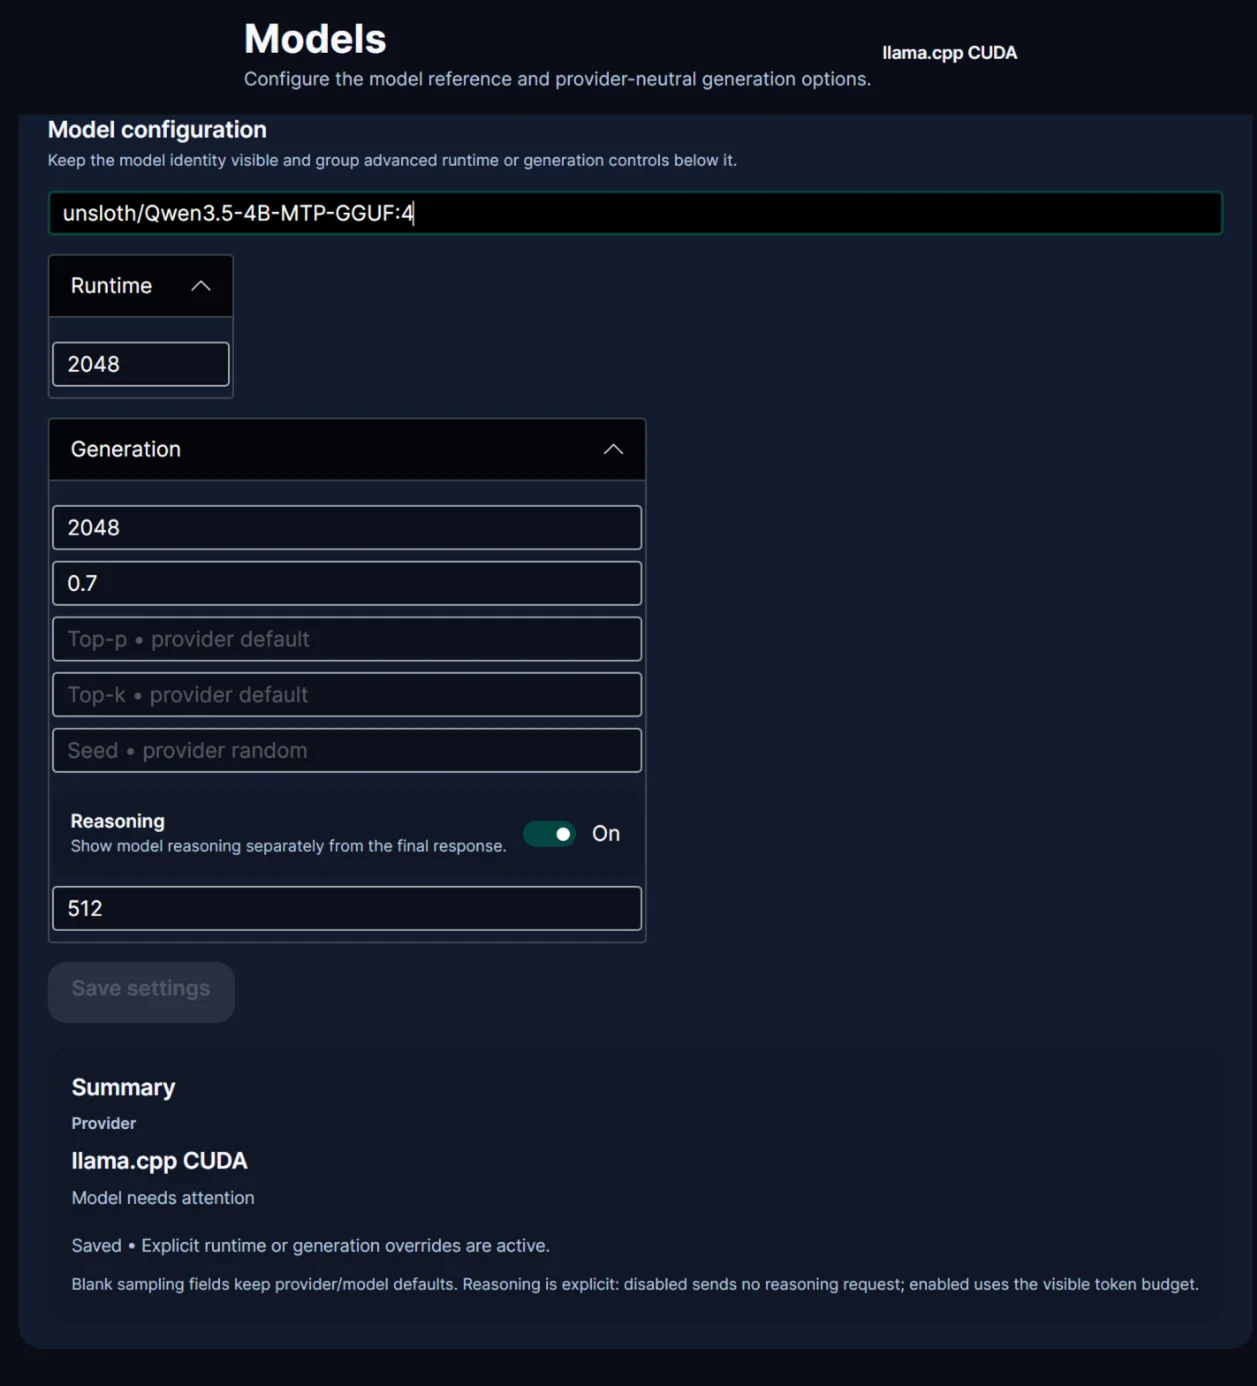
  • Interface Avalonia avec espaces Conversations, Provider et Models.
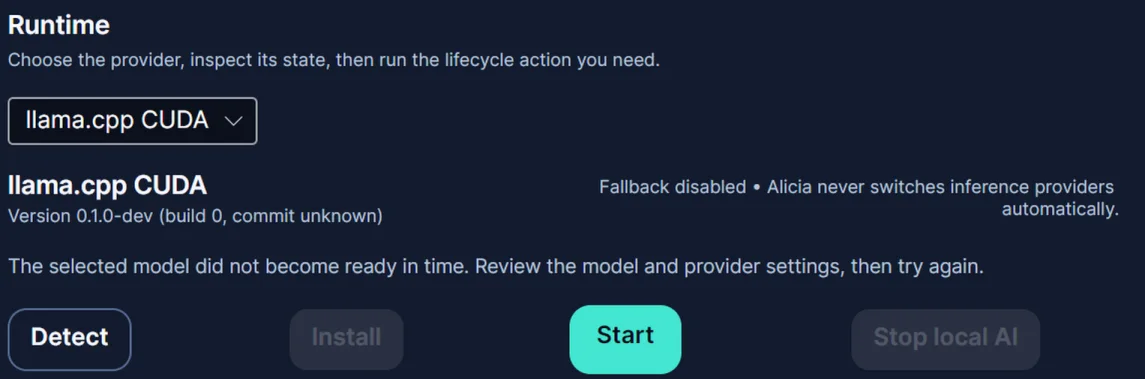
  • Adaptateur local llama.cpp CUDA, détection/installation gérée sur Linux x64 et cycle de vie explicite.
  • Configuration d’un modèle GGUF Hugging Face et des paramètres de génération, dont le reasoning borné.
  • Streaming SSE séparant contenu visible et reasoning ; seule la réponse Assistant terminée est persistée.
  • Stop et retry explicite sans replay automatique des requêtes de génération.
  • Observabilité locale bornée et sans contenu : latences, tokens, version fournisseur et classification sûre des échecs.

Difficultés

Difficultés résolues

  • Piloter un runtime local. Détection, installation, démarrage, readiness, ownership et arrêt sont gérés sans exposer de secrets sur la ligne de commande.
  • Gérer le streaming dans l’interface. Le suivi de scroll, l’annulation et le retry restent contrôlés par l’utilisateur.

Qualité

Tests et garde-fous

  • Tests des couches Domain, Application, Infrastructure, Presentation et Architecture.
  • La frontière Presentation → Infrastructure est vérifiée automatiquement.

Livraison

Livraison et CI/CD

  • Toolchain .NET 10 épinglée.
  • Les commandes Makefile regroupent build, tests, architecture et vérifications.

Résultats

Résultats observables

  • Conversation locale persistante avec génération et streaming via llama.cpp.
  • Gestion explicite du fournisseur, du modèle et de la maintenance locale.

Compromis

Compromis techniques

  • L’installation gérée de llama.cpp CUDA cible actuellement Linux x64 avec NVIDIA ; les autres hôtes peuvent utiliser un runtime compatible déjà installé.
  • Le reasoning affiché reste un snapshot Presentation en mémoire dans l’état actuel.

Limites

Les limites actuelles

  • Version de travail documentée : les captures et capacités décrites peuvent différer de la branche principale du dépôt public.
  • Pas de tool calling, RAG/retrieval, pièces jointes ou multimodalité.
  • Installation gérée CUDA limitée à Linux x64 pour le lot actuel.

Suite

Prochaines étapes

  • Étendre les capacités uniquement par lots atomiques derrière les contrats existants.

Captures

Quelques écrans pour parcourir le projet.

Synthèse

Compétences et techniques mobilisées

  • Les contrats Application restent indépendants de llama.cpp, CUDA et HTTP.
  • Les conversations et la configuration fournisseur/modèle sont persistées localement sans stocker les secrets dans les documents de conversation.
  • Tool calling, retrieval/RAG, pièces jointes et multimodalité ne sont pas implémentés dans le périmètre actuel.

Aperçu agrandi